· 7 min de leitura
Como justificar o monitoramento online com o custo de uma parada não programada
Um método prático para montar o business case do monitoramento de vibração online a partir do custo real de uma parada não programada e do seu histórico.
Andrés González
"Quanto o monitoramento online vai nos economizar?" A pergunta costuma receber uma resposta fraca: um ROI tirado de catálogo ou a história da última falha. Nenhuma resiste a uma análise financeira séria.
Dá para construir uma resposta sólida com dados que a planta já tem. Veja um método simples para estimar quanto custa de verdade uma parada não programada, quanto desse custo a antecipação consegue evitar e como comparar isso com o custo do serviço, sem prometer resultados que ninguém pode garantir.
Passo 1: o custo real de uma parada não programada
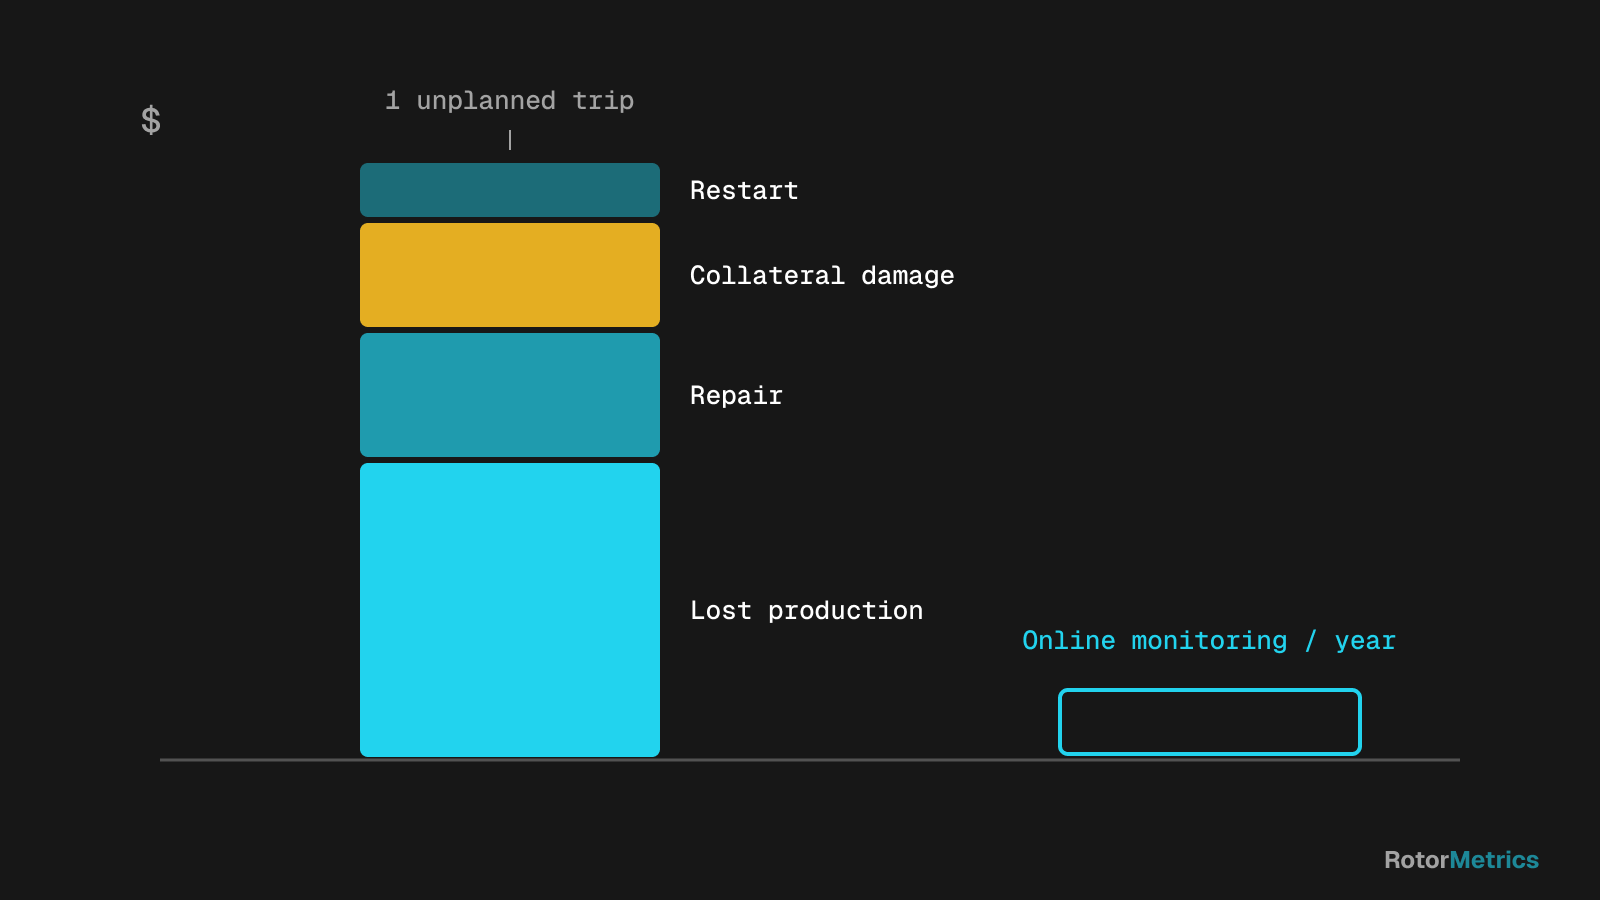
Uma parada não programada custa muito mais que o reparo. Separe em blocos, porque cada um vem de uma fonte de dados diferente.
Produção perdida (margem, não receita)
O erro clássico é multiplicar as horas paradas pela receita por hora. O correto é usar a margem de contribuição perdida: receita menos os custos variáveis que deixam de existir com a unidade parada (matéria-prima, energia, catalisador). E pergunte se a produção é perdida ou só adiada: com estoque, capacidade de recuperação ou trem paralelo, a perda real é menor.
Reparo
- Peças: mancais, selos, labirintos, palhetas, às vezes um rotor reserva.
- Mão de obra própria e de terceiros, com horas extras.
- Serviço do fabricante (OEM): supervisores de campo, balanceamento em oficina, frete urgente.
Dano colateral
Aqui a antecipação faz mais diferença. Um mancal trocado quando começa a se degradar é serviço de dias. Se falhar em operação, pode levar os selos, danificar o munhão ou provocar roçamento no rotor, e a conversa passa a ser de semanas e de peças com longo prazo de entrega.
Partida, flare, multas e segurança
- Custo de nova partida: purga, estabilização do processo, produto fora de especificação.
- Queima no flare, com exposição ambiental e regulatória.
- Multas contratuais por atraso de entregas.
- Risco às pessoas. Muitas vezes fica sem valor monetário, mas precisa constar no caso.
Duração
Use a duração típica dos seus eventos, não a do pior caso. Separe diagnóstico, espera de peças, reparo e nova partida; quase sempre a espera de peças pesa mais.
Passo 2: probabilidade e frequência, com o seu histórico
Também é preciso saber com que frequência o evento acontece. A regra é rígida: use o seu histórico, não números da indústria sem contexto.
- Levante ordens de serviço, livros de turno e relatórios de falha dos últimos 10 a 15 anos.
- Conte as paradas não programadas por modo de falha: desbalanceamento, desalinhamento, roçamento, instabilidade de filme de óleo, mancal de escora, selos.
- Se uma máquina tem pouco histórico, agrupe equipamentos semelhantes da sua frota.
- Registre quais eventos deram sinal na vibração antes da falha. Nem todo modo de falha é detectável por vibração.
O resultado é uma frequência anual por modo de falha (um evento a cada cinco anos equivale a 0,2 por ano) e uma noção de que fração é detectável.
Passo 3: a curva P-F e o valor da antecipação
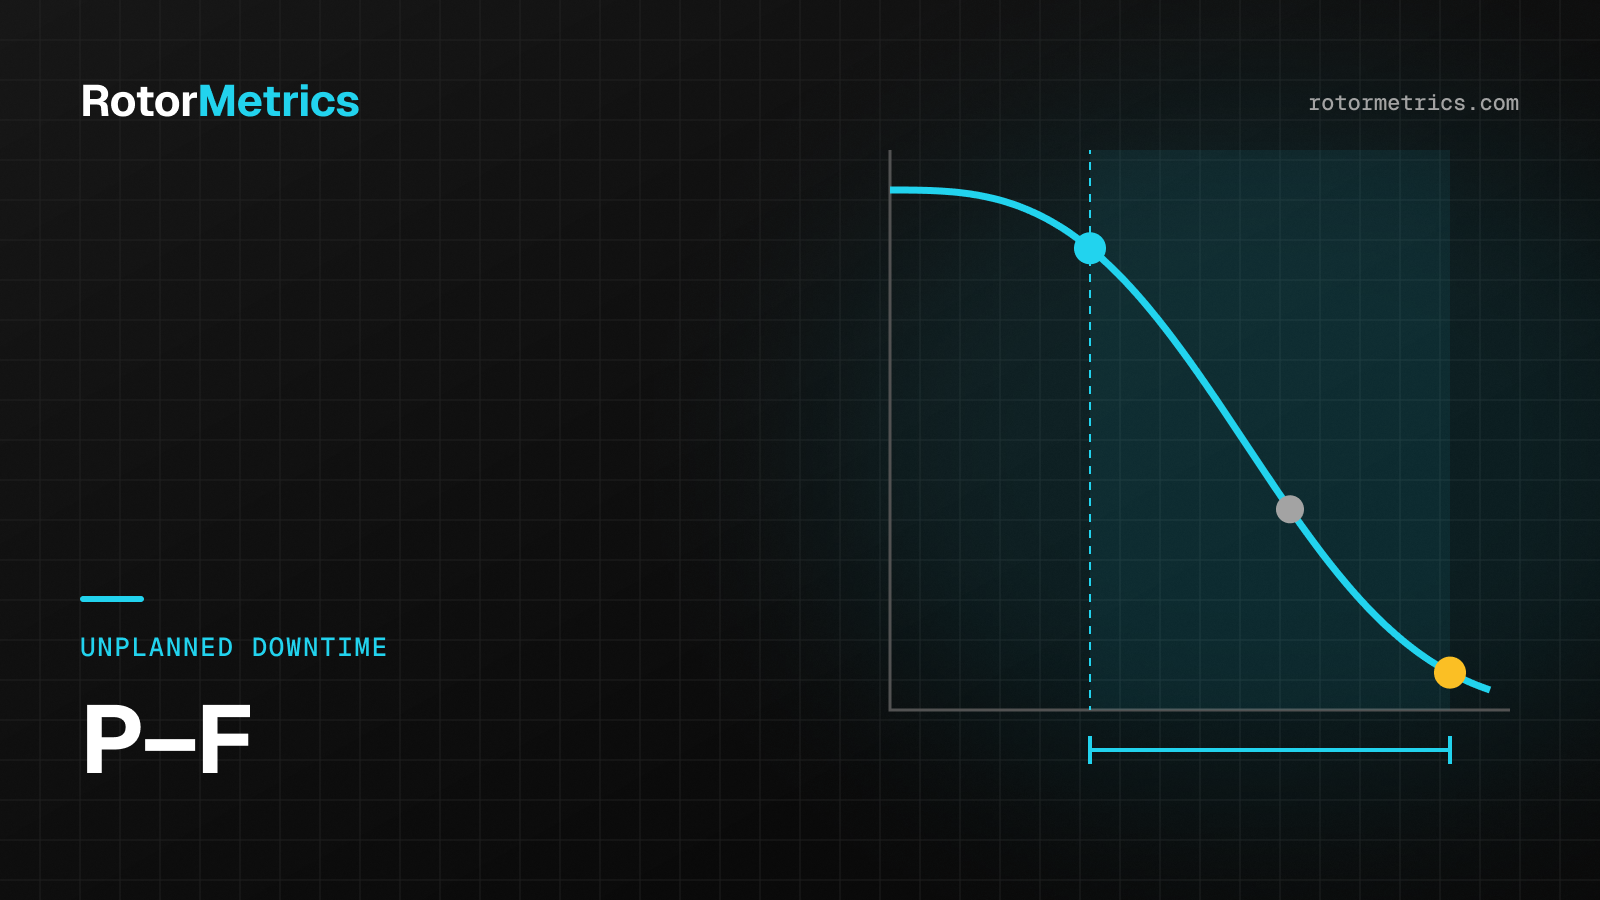
A curva P-F descreve como um equipamento se deteriora. No ponto P a falha já começou e pode ser detectada; no ponto F ocorre a falha funcional. O tempo entre os dois é o intervalo P-F, e o que importa é quanto dele ainda resta quando você fica sabendo.
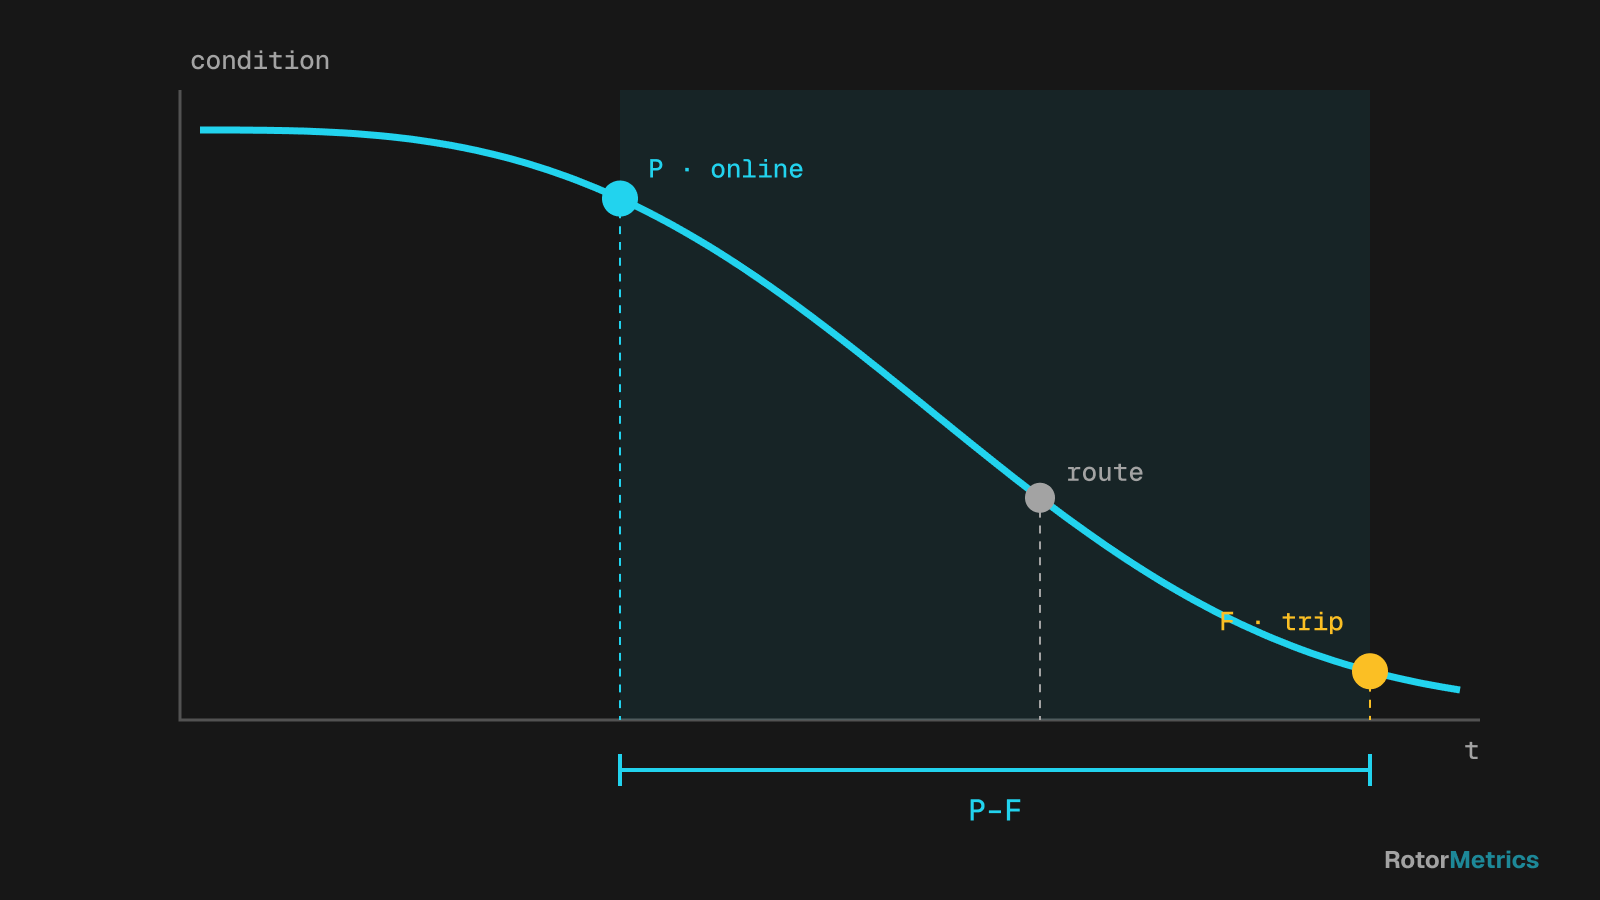
- Só proteção: o sistema de proteção conforme a API 670 foi feito para dar trip na máquina, não para avisar com semanas de antecedência. Quando ele atua, normalmente você já está perto de F e a parada é não programada.
- Rotas periódicas: dependem da frequência da rota. Se a coleta é mensal e o intervalo P-F daquele modo de falha é de duas ou três semanas, pode ser que você nunca o veja.
- Monitoramento contínuo: acompanha o tempo todo a tendência de amplitude e fase 1X, 2X, componentes subsíncronas, linha de centro do eixo e posição axial. Tipicamente detecta mais perto de P e dá dias ou semanas para planejar.
Alguns modos de falha têm intervalos P-F curtos. Na instabilidade de filme de óleo, a diferença é de horas, não de semanas (veja instabilidade de filme de óleo: oil whirl e oil whip). Outros, como um desbalanceamento que cresce por incrustação, avançam devagar o bastante para que até uma rota mensal os pegue. Por isso a análise precisa ser feita modo de falha por modo de falha.
O valor global pode estar bem abaixo do alarme enquanto uma componente subsíncrona já aparece no espectro.
Passo 4: a conta
A fórmula é propositalmente simples:
Custo evitado esperado por ano = f × p × (C_não_programado − C_planejado)
- f: frequência anual do modo de falha (do seu histórico).
- p: probabilidade de detectá-lo com antecedência suficiente para planejar (estimativa conservadora, por modo de falha).
- C_não_programado: custo total do evento quando pega todos de surpresa (todos os blocos do passo 1).
- C_planejado: custo de tratar o mesmo problema numa janela planejada.
Esse valor é comparado com o custo anual do serviço de monitoramento. Este é o modelo:
| Item | Como estimar | Fonte de dados |
|---|---|---|
| Margem perdida por hora | Receita menos custos variáveis evitados | Financeiro, planejamento |
| Duração não programada (h) | Mediana dos seus eventos | Livros de turno, ordens de serviço |
| Reparo não programado | Peças, mão de obra, OEM, urgências | Custos de eventos anteriores |
| Dano colateral | Peças adicionais quando a falha avançou | Relatórios de falha, OEM |
| Partida, flare, multas | Por evento | Operação, meio ambiente, comercial |
| Custo planejado | Mesmo reparo em janela programada | Planejamento de manutenção |
| f (eventos/ano) | Contagem por modo de falha | Histórico de 10 a 15 anos |
| p (detecção a tempo) | Conservador, por modo de falha | Julgamento técnico documentado |
| Custo anual do serviço | Proposta mais custos internos | Fornecedor, TI, engenharia |
Exemplo ilustrativo (hipotético)
Os números abaixo foram inventados para mostrar o método. Não representam nenhuma planta e não são um resultado esperado.
Um turbocompressor com margem perdida de USD 8.000 por hora:
- Parada não programada: 72 h × 8.000 = 576.000; reparo com dano colateral 300.000; nova partida e flare 50.000. C_não_programado ≈ USD 926.000.
- Mesmo problema detectado a tempo: 24 h × 8.000 = 192.000; reparo sem dano colateral 120.000. C_planejado ≈ USD 312.000.
- Diferença por evento ≈ USD 614.000.
- Histórico: um evento a cada quatro anos, f = 0,25. Detecção a tempo estimada, p = 0,6.
Custo evitado esperado = 0,25 × 0,6 × 614.000 ≈ USD 92.000 por ano, contra um custo hipotético do serviço de USD 40.000 por ano.
Agora a parte honesta: se o histórico mostra um evento a cada dez anos (f = 0,1), o valor esperado cai para cerca de USD 37.000 por ano e deixa de cobrir o serviço só com essa máquina. Também é uma resposta útil: talvez valha avaliar um grupo de máquinas, ou essa máquina não seja a prioridade.
Erros comuns
- Usar receita em vez de margem.
- Tratar o pior evento do histórico como se fosse o típico.
- Assumir p = 1. Nenhum monitoramento pega tudo, nem sempre a tempo.
- Esquecer os custos internos do monitoramento: tratamento de alarmes, tempo de engenharia, TI e cibersegurança.
- Apresentar o ROI como garantia. É um valor esperado, com incerteza.
- Deixar o risco de segurança de fora porque "não tem número".
O que levar para a gerência
- Uma página com as máquinas críticas, o custo por hora de parada (margem) e o histórico de eventos.
- O modelo preenchido, com a fonte de cada dado e as premissas destacadas.
- Uma faixa, não um número: cenários conservador, base e otimista, mais a sensibilidade a f e p.
- O que não se monetiza: segurança, meio ambiente, reputação com clientes.
- Como será medido: quais indicadores serão revistos em 12 meses (alertas emitidos, intervenções planejadas, paradas evitadas documentadas).
Para revisar o que a vibração mostra, leia como detectar falhas em turbocompressores com análise de vibração e, sobre o papel da proteção, API 670 explicado.
Como fazemos na RotorMetrics
Pegamos o sinal do seu sistema de proteção existente, como um Bently Nevada 3500, sem intervir nele. Nossos especialistas acompanham tendências, espectros e órbitas continuamente e avisam quando algo muda, com uma recomendação concreta. Se quiser, ajudamos a preencher o modelo com os seus dados antes de decidir.
Fontes
- American Petroleum Institute. API Standard 670: Machinery Protection Systems, 5ª ed., 2014.
- Moubray, J. Reliability-Centred Maintenance (RCM II), 2ª ed. Industrial Press, 1997.
- Nowlan, F. S.; Heap, H. F. Reliability-Centered Maintenance. United Airlines / U.S. Department of Defense, 1978.
- Bently, D. E.; Hatch, C. T. Fundamentals of Rotating Machinery Diagnostics. Bently Pressurized Bearing Press, 2002.
- ISO 17359: Condition monitoring and diagnostics of machines — General guidelines.
Quer que monitoremos sua máquina?
Vamos conversar sobre seus equipamentos críticos e mostramos como os monitoraríamos.
Agende uma conversa