· 7 min de lectura
Cómo justificar el monitoreo en línea con el costo de un paro no programado
Un método práctico para armar el caso de negocio del monitoreo de vibraciones en línea con el costo real de un paro no programado y tu propio historial.
Andrés González
"¿Cuánto nos ahorra el monitoreo en línea?" suele responderse mal: con un ROI copiado de un folleto o con la anécdota de la última falla. Ninguna aguanta una revisión financiera seria.
La respuesta se puede construir con datos que tu planta ya tiene. Aquí proponemos un método sencillo para estimar el costo de un paro no programado, cuánto de ese costo se puede evitar con anticipación y cómo compararlo con el costo del servicio, sin prometer resultados que nadie puede garantizar.
Paso 1: el costo real de un paro no programado
Un paro no programado cuesta mucho más que la reparación. Sepáralo en bloques, porque cada uno tiene su propia fuente de datos.
Producción perdida (margen, no ingreso)
El error más común es multiplicar las horas de paro por el ingreso por hora. Lo correcto es usar el margen de contribución perdido: el ingreso menos los costos variables que no se gastan mientras la planta está parada (materia prima, energía, catalizador). Pregunta también si la producción se pierde o solo se difiere: si hay inventario, capacidad de recuperación o un tren paralelo, la pérdida real es menor.
Reparación
- Piezas: cojinetes, sellos, laberintos, álabes, a veces un rotor de repuesto.
- Mano de obra propia y contratistas, incluidas horas extra.
- Servicio del fabricante (OEM): supervisores, balanceo en taller, envíos urgentes.
Daño colateral
Aquí está la gran diferencia. Un cojinete cambiado cuando empieza a degradarse es trabajo de días. Si falla en operación puede llevarse sellos, el muñón o rozar el rotor, y se habla de semanas y de piezas con largos tiempos de entrega.
Arranque, flare, penalizaciones y seguridad
- Costo de rearranque: purgas, estabilización del proceso, producto fuera de especificación.
- Quema en flare y su impacto ambiental o regulatorio.
- Penalizaciones contractuales por incumplimiento de entregas.
- Riesgo para las personas: a veces no se monetiza, pero debe aparecer en el caso.
Duración
Usa la duración típica de tus eventos, no la del peor caso. Separa diagnóstico, espera de piezas, reparación y rearranque: casi siempre domina la espera de piezas.
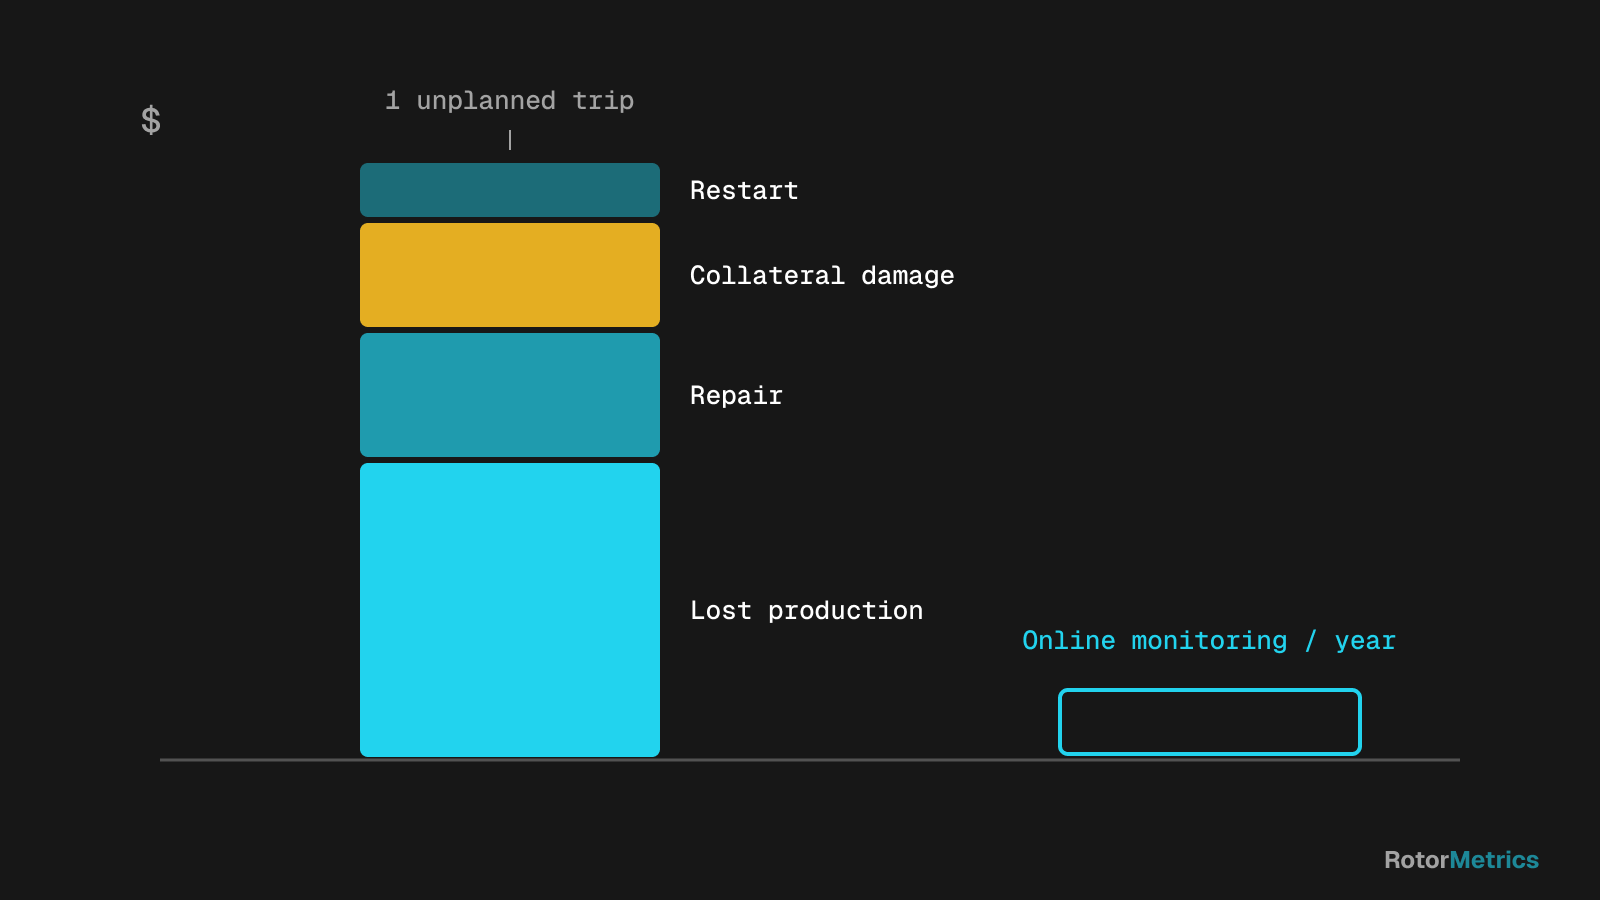
Paso 2: probabilidad y frecuencia, con tu propio historial
El costo de un evento no basta: hay que saber cada cuánto ocurre. Aquí la regla es estricta: usa tu historial, no cifras de la industria sin contexto.
- Revisa órdenes de trabajo, bitácoras de operación y reportes de falla de los últimos 10 a 15 años.
- Cuenta los paros no programados por modo de falla: desbalance, desalineación, roce, inestabilidad, cojinete de empuje, sellos.
- Si una máquina tiene poca historia, agrupa equipos similares de tu flota.
- Anota cuáles dieron señal en la vibración antes de fallar. No todos los modos de falla son detectables por vibración.
El resultado es una frecuencia anual por modo de falla (por ejemplo, un evento cada cinco años equivale a 0.2 por año) y una idea de qué fracción es detectable.
Paso 3: la curva P-F y el valor de la anticipación
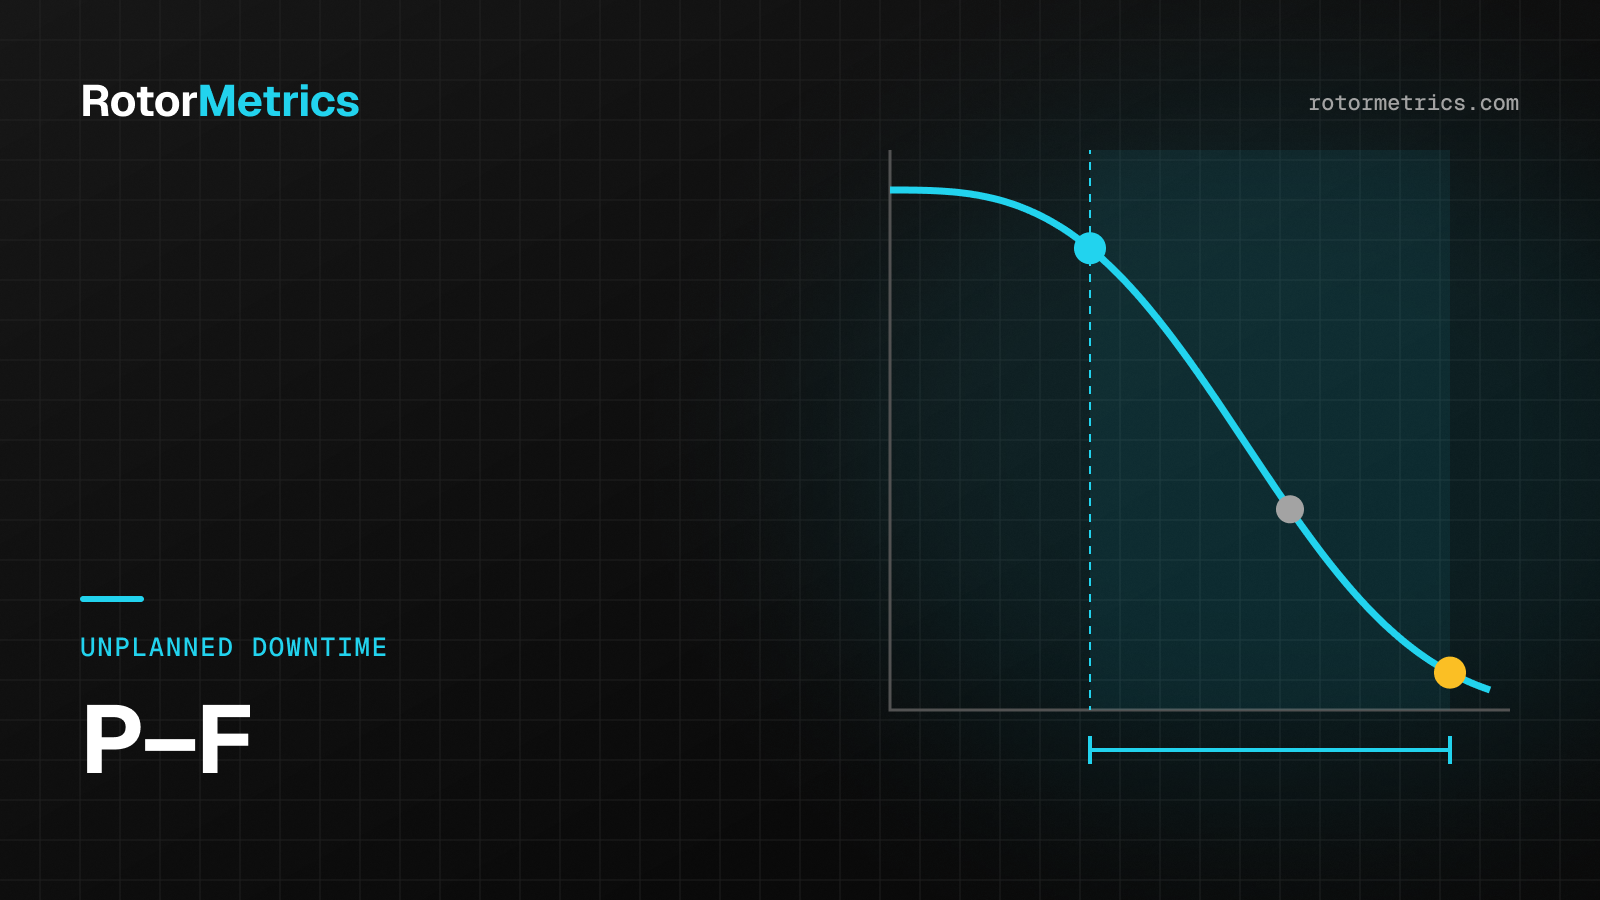
La curva P-F describe cómo se deteriora un equipo: en el punto P la falla ya empezó y es detectable; en el punto F ocurre la falla funcional. El tiempo entre ambos es el intervalo P-F, y lo que importa es cuánto de ese intervalo te queda cuando te enteras.
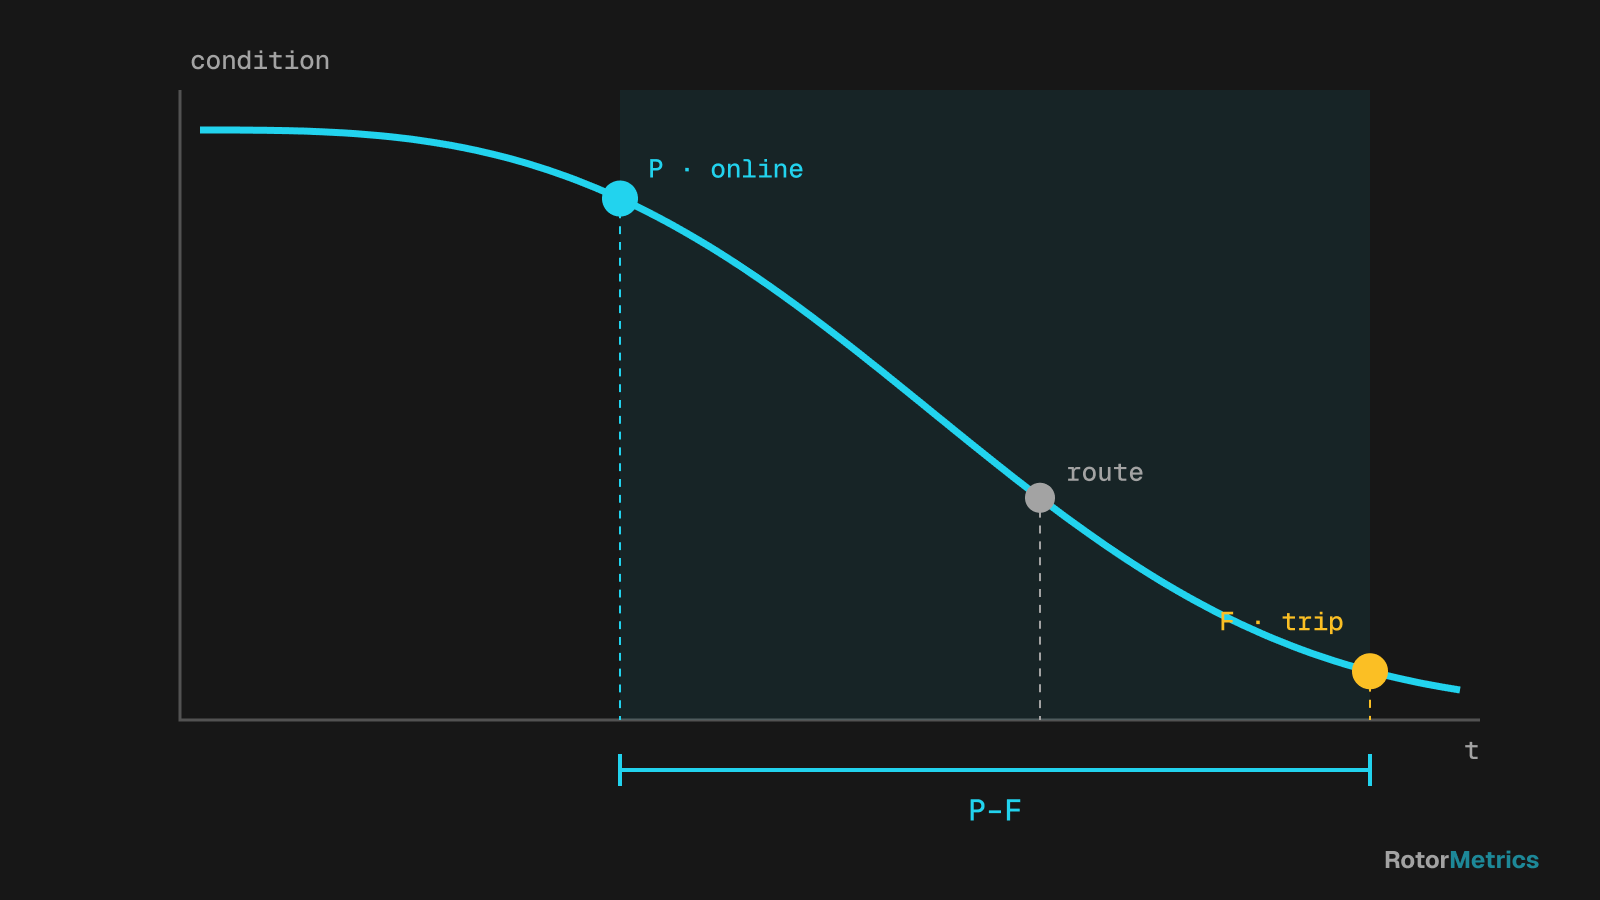
- Solo protección: el sistema de protección según API 670 está diseñado para disparar la máquina, no para avisar con semanas de anticipación. Cuando actúa, normalmente ya estás cerca de F y el paro es no programado.
- Rutas periódicas: dependen de la frecuencia de la ruta. Si mides cada mes y el intervalo P-F de ese modo de falla es de pocas semanas, puedes no verlo nunca.
- Monitoreo continuo: revisa tendencias de amplitud y fase 1X, 2X, subsíncronas, línea central y posición axial todo el tiempo. Típicamente detecta más cerca de P y da días o semanas para planear.
Hay fallas con intervalos P-F cortos, como la inestabilidad por película de aceite, donde la diferencia es de horas, no de semanas (lo explicamos en inestabilidad por película de aceite: oil whirl y oil whip). Otras, como un desbalance que crece por ensuciamiento, avanzan lento y dan margen incluso a una ruta mensual. Por eso el análisis se hace por modo de falla.
Un ejemplo de lo que el valor global no muestra: el global puede estar lejos de la alarma mientras una componente subsíncrona ya aparece en el espectro.
Paso 4: el cálculo
La fórmula es deliberadamente simple:
Valor esperado evitado por año = f × p × (C_no_programado − C_planeado)
- f: frecuencia anual del modo de falla (de tu historial).
- p: probabilidad de detectarlo con anticipación suficiente para planear (estimación conservadora, por modo de falla).
- C_no_programado: costo total del evento cuando sorprende (todos los bloques del paso 1).
- C_planeado: costo de atender el mismo problema en una ventana planeada.
Ese valor se compara con el costo anual del servicio de monitoreo. Esta es la plantilla:
| Concepto | Cómo estimarlo | Fuente de datos |
|---|---|---|
| Margen perdido por hora | Ingreso menos costos variables evitados | Finanzas, planeación |
| Duración no programada (h) | Mediana de eventos propios | Bitácoras, órdenes de trabajo |
| Reparación no programada | Piezas, mano de obra, OEM, urgencias | Costos de eventos anteriores |
| Daño colateral | Piezas adicionales cuando la falla avanzó | Reportes de falla, OEM |
| Rearranque, flare, penalizaciones | Por evento | Operaciones, ambiental, comercial |
| Costo planeado | Misma reparación en ventana programada | Planeación de mantenimiento |
| f (eventos/año) | Conteo por modo de falla | Historial de 10 a 15 años |
| p (detección a tiempo) | Conservador, por modo de falla | Juicio técnico documentado |
| Costo anual del servicio | Cotización, más costos internos | Proveedor, TI, ingeniería |
Ejemplo ilustrativo (hipotético)
Las cifras siguientes son inventadas para mostrar el método. No representan a ninguna planta ni son un resultado esperado.
Un turbocompresor con un margen perdido de 8,000 USD/h:
- Paro no programado: 72 h × 8,000 = 576,000; reparación con daño colateral 300,000; rearranque y flare 50,000. C_no_programado ≈ 926,000 USD.
- Mismo problema detectado a tiempo: 24 h × 8,000 = 192,000; reparación sin daño colateral 120,000. C_planeado ≈ 312,000 USD.
- Diferencia por evento ≈ 614,000 USD.
- Historial: un evento cada cuatro años, f = 0.25. Detección a tiempo estimada p = 0.6.
Valor esperado evitado = 0.25 × 0.6 × 614,000 ≈ 92,000 USD por año, frente a un costo hipotético del servicio de 40,000 USD por año.
Ahora el ejercicio honesto: si el historial dice un evento cada diez años (f = 0.1), el valor esperado baja a unos 37,000 USD por año y ya no cubre el servicio en esa máquina sola. También es un resultado útil: quizá conviene evaluar un grupo de máquinas, o esa máquina no es la prioridad.
Errores comunes
- Usar ingreso en lugar de margen.
- Tomar el peor evento de la historia como si fuera el típico.
- Suponer p = 1: ningún monitoreo detecta todo, ni siempre a tiempo.
- Olvidar los costos internos del monitoreo: atención de alarmas, tiempo de ingeniería, TI y ciberseguridad.
- Presentar un ROI como garantía. Es un valor esperado, con incertidumbre.
- No incluir el riesgo de seguridad porque "no tiene número".
Qué presentar a la gerencia
- Una página con las máquinas críticas, su costo por hora de paro (margen) y su historial de eventos.
- La plantilla llena, con la fuente de cada dato y los supuestos marcados.
- Un rango, no un número: escenario conservador, base y optimista, y la sensibilidad a f y p.
- Lo que no se monetiza: seguridad, ambiente, reputación con clientes.
- Cómo se medirá: qué indicadores revisarán en 12 meses (avisos emitidos, intervenciones planeadas, paros evitados documentados).
Si quieres repasar qué fallas deja ver la vibración, revisa cómo detectar fallas en turbocompresores con análisis de vibraciones y, para el papel de la protección, API 670 explicado.
Cómo lo hacemos en RotorMetrics
Tomamos la señal de tu sistema de protección existente, como un Bently Nevada 3500, sin intervenirlo. Nuestros especialistas revisan tendencias, espectros y órbitas de forma continua y te avisan cuando algo cambia, con una recomendación concreta. Si nos lo pides, te ayudamos a llenar la plantilla con tus propios datos antes de que decidas nada.
Fuentes
- American Petroleum Institute. API Standard 670: Machinery Protection Systems, 5.ª ed., 2014.
- Moubray, J. Reliability-Centred Maintenance (RCM II), 2.ª ed. Industrial Press, 1997.
- Nowlan, F. S. y Heap, H. F. Reliability-Centered Maintenance. United Airlines / U.S. Department of Defense, 1978.
- Bently, D. E. y Hatch, C. T. Fundamentals of Rotating Machinery Diagnostics. Bently Pressurized Bearing Press, 2002.
- ISO 17359: Condition monitoring and diagnostics of machines — General guidelines.
¿Quieres que vigilemos tu máquina?
Platiquemos de tus equipos críticos y te mostramos cómo los monitorearíamos.
Agenda una llamada